Projet 01
Job Agent
Recherche d'emploi automatisée
- Année
- 2026
- Univers
- Système / agents / automatisation
- Preuve
- Démo en ligne · Dépôt public
- Statut
- En ligne
931offres scorées, pipeline entièrement tracé
Serveur gratuit mis en veille : le premier chargement prend environ une minute.
En bref
- Friction
- Les offres sont éparpillées sur plusieurs sites (Hellowork, jobup.ch, LinkedIn), et il faut lire chacune en entier pour savoir si elle correspond à ce que l'on cherche et à son profil.
- Système
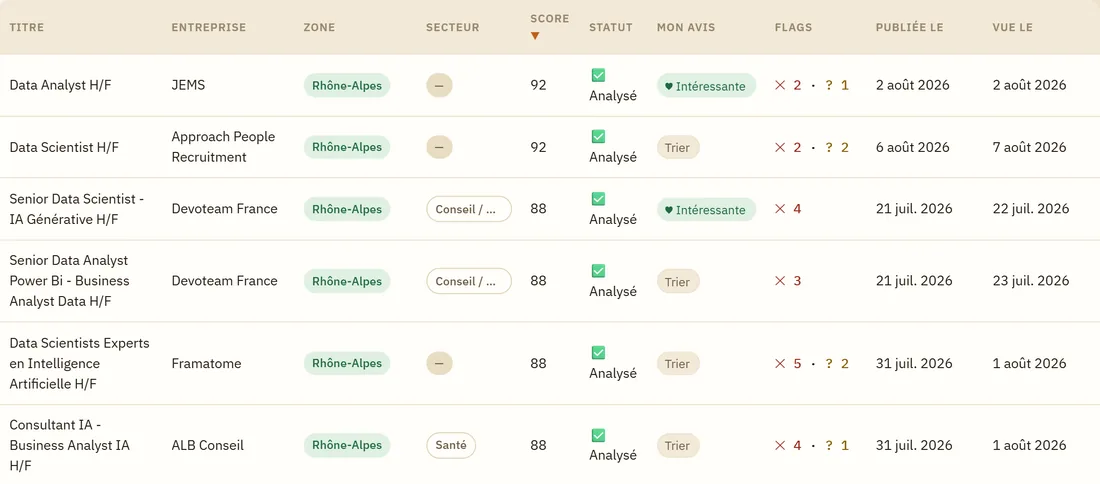
- Pipeline multi-agents : scraping → RAG sur le profil candidat → agent de scoring (géographie déterministe + matching sémantique par atome + arbitrage LLM) → agent de génération d'analyse → API + dashboard de tri. Aucune soumission automatique.
- Résultat
- 931 offres scorées sur trois sources, 3 niveaux de trace JSON par offre pour audit complet.
Le film — 1 min 11
Lire le texte du film
Quand on cherche un poste, on refait chaque jour la même tournée : on ouvre trois sites d'annonces, et sur chacun, on cherche data analyst, puis data scientist, puis ingénieur IA… et on recommence pour Lyon, puis pour la Suisse, puis pour les Émirats. Et après, il faut encore lire chaque offre en entier pour savoir si elle vaut le coup.
Ce n'est pas difficile… c'est juste très répétitif.
Alors j'ai construit Job Agent, pour tout regrouper au même endroit : les sites, les postes, et les régions. Chaque matin, il va chercher les offres à ma place. Ensuite, il compare chacune à mon profil, et il lui donne une note sur cent. Moi, je n'ai plus qu'à ouvrir le brief du jour, et à trier : oui, non, peut-être.
Et ce qui compte pour moi, c'est qu'il reste honnête : pour chaque offre, il liste mes points forts, et s'il me manque une compétence, il l'écrit aussi, noir sur blanc, au lieu de gonfler la note. Et surtout, il n'envoie jamais une candidature tout seul.
Job Agent. Il prépare, je décide.
Friction
Chercher un poste, c'était refaire chaque jour la même tournée : ouvrir Hellowork, jobup.ch et LinkedIn, parcourir les nouvelles offres, puis lire chacune en entier pour savoir si elle correspondait à ce que je cherchais et à mon profil.
Le travail n'est pas difficile, il est répétitif. Et chaque site ou chaque zone géographique ajoutée rallonge la tournée d'autant.
L'idée est donc simple : réunir au même endroit toutes les offres que j'allais chercher à la main, et noter chacune selon mes critères avant même de l'ouvrir.
Construction
Un pipeline multi-agents qui va du scraping jusqu'à une analyse rédigée : collecte des offres sur Hellowork, jobup.ch et LinkedIn, indexation RAG du profil candidat, agent de scoring, agent de génération d'analyse structurée, puis une API et un dashboard de tri manuel.
Un script enchaîne des étapes sans condition. L'orchestrateur décide. Il relance un scraping ciblé, assume un statut « incertain », gère explicitement ses échecs.
Un garde-fou n'est pas négociable : aucune soumission automatique de candidature. Le pipeline s'arrête à l'analyse, et la validation humaine reste le seul chemin vers une action externe.
Système
JOB SOURCES [ AGENT · AGENT · AGENT ] FILTER MATCH OUTPUT
Le RAG est écrit à la main, sans LangChain. Embeddings multilingues locaux via sentence-transformers, indexation vectorielle dans ChromaDB, seuil de bruit calculé dynamiquement. La recherche porte sur l'atome de compétence, pas sur l'exigence composite.
Le scoring combine trois régimes volontairement distincts : la géographie est traitée en déterministe, hors du RAG ; le rapprochement de compétences passe par la recherche sémantique ; l'arbitrage final revient à un agent LLM (API Mistral), qui extrait aussi les exigences de l'offre et rédige l'analyse structurée.
L'ensemble tourne seul : scraping programmé par cron quotidien sur GitHub Actions, pipeline de bout en bout sans intervention jusqu'à l'analyse, nettoyage automatique des offres obsolètes, et chaque offre écrite dans Postgres dès qu'elle est traitée.
Une même offre, deux granularités de la même mesure. En composite, chaque exigence est confrontée au profil en un bloc. En atomique, elle est éclatée en ses composants avant d'être confrontée un par un. Ouvrez n'importe quelle ligne pour voir sa décomposition, que le bouton ci-dessous soit utilisé ou non.
Offre 24 (trace_24.json / trace_24_atomic.json) · Traces réelles du pipeline de scoring RAG, non rejouées. Aucun score global : ces distances mesurent la proximité sémantique d'une exigence à un chunk du profil, pas un score de matching global.
Vue composite : 10 exigences → 10 retenus → 0 signal.
- gouvernance et gestion des données QMS (ISO 13485, FDA 21 CFR Part 820, EU MDR)0,536 · retenu
- ISO 134850,763 · aucun match fiable
- FDA 21 CFR Part 8200,651 · retenu
- EU MDR0,563 · retenu
- gouvernance des données QMS0,519 · retenu
- gestion des données QMS0,489 · retenu
- traçabilité des données0,583 · retenu
- disponibilité des données0,506 · retenu
Six des sept composants de cette exigence sont couverts. ISO 13485 ne l'est pas : le résultat composite ne montrait pas cette absence.
- nettoyage/validation/fiabilisation de données (structurées et non structurées)0,523 · retenu
- analyse statistique avancée (tests, régression, distributions, modélisation prédictive)0,481 · retenu
- développement et automatisation de KPIs/dashboards qualité0,460 · retenu
- data mining et extraction d'insights à partir de sources variées0,458 · retenu
- machine learning (feature selection, optimisation de classificateurs, modèles prédictifs)0,179 · retenu
- traitement de grands jeux de données dans un environnement régulé0,507 · retenu
- maîtrise des outils de reporting et d'analyse (ex: Python, R, SQL, outils BI)0,257 · retenu
- support aux audits réglementaires et conformité des données0,472 · retenu
- collaboration avec les équipes IT/Qualité pour l'amélioration des systèmes0,445 · retenu
Les 9 autres exigences, vues par le pipeline atomique9 exigences
Le pipeline atomique reformule les exigences avant de les décomposer : leur texte diffère de celui de la trace composite ci-dessus, même s'il s'agit du même profil de poste. Aucune correspondance ligne à ligne n'est affirmée ici.
- cartographie et intégration des sources de données5 atomes, meilleure distance 0,488 · retenu
- qualité et intégrité des données6 atomes, meilleure distance 0,446 · retenu
- prétraitement et exploration des données (structurées et non structurées)6 atomes, meilleure distance 0,449 · retenu
- développement et automatisation de KPI et tableaux de bord qualité5 atomes, meilleure distance 0,331 · retenu
- analyse statistique et modélisation prédictive8 atomes, meilleure distance 0,378 · retenu
- machine learning et algorithmes de classification5 atomes, meilleure distance 0,186 · retenu
- support aux audits réglementaires et internes7 atomes, meilleure distance 0,470 · retenu
- expertise des outils de reporting et systèmes qualité7 atomes, meilleure distance 0,462 · retenu
- expérience dans les environnements réglementés (médical, pharmaceutique, aérospatial)7 atomes, meilleure distance 0,473 · retenu
Données
931 offres scorées en base au 11 novembre 2026 : 443 sur LinkedIn, 320 sur jobup.ch, 168 sur Hellowork. Elles vivent dans Postgres (Neon), qui a remplacé SQLite : les 913 offres de l'ancienne base y ont été importées, identifiants conservés.
Chaque offre porte trois niveaux de trace JSON. N'importe quelle décision du pipeline peut être rouverte et auditée a posteriori, étape par étape.
Python 3.11 · Playwright · Postgres (Neon) · ChromaDB · sentence-transformers · API Mistral · FastAPI · Docker · GitHub Actions · Render
Résultat
Le résultat le plus intéressant n'est pas le volume : la granularité atomique du RAG détecte des gaps de compétence qu'une recherche composite manque silencieusement. Vérifié sur une offre réelle, qui exigeait la norme ISO 13485.
Le système est honnête par construction : il ne fabrique jamais une compétence, et signale un manque explicitement plutôt que de le masquer dans un score global.
Recul
Le système fonctionne aujourd'hui comme un jugement contre un profil statique : CV et critères alimentent le scoring, mais les décisions prises au fil des sessions ne retournent pas encore dans la boucle.
Le principal axe que je développerais serait donc une boucle de réapprentissage à partir des verdicts utilisateur. Les décisions « intéressante » / « pas pour moi » sont déjà conservées dans user_verdict, mais ne nourrissent pas encore le scoring. Avec suffisamment de verdicts, je pourrais les réinjecter dans ChromaDB comme exemples afin que l'agent affine progressivement son jugement à partir des décisions réelles plutôt que du seul profil initial.
Lire le recul complet
Ce mécanisme devrait cependant attendre un volume suffisant de verdicts pour éviter d'apprendre sur trop peu d'exemples.
Un second axe serait de détecter les modifications substantielles d'une offre lors du re-scraping et de relancer automatiquement son analyse. Aujourd'hui, une offre reste associée à son analyse initiale même si son contenu évolue.