Projet 02
ARAM Stats
Statistiques du mode ARAM : Mayhem
- Année
- 2026
- Univers
- Data / gaming / statistiques
- Preuve
- Démo en ligne · Aucune donnée de joueur
- Statut
- En ligne
+150 000parties collectées
En bref
- Friction
- ARAM : Mayhem est un mode de League of Legends où chaque joueur choisit des améliorations, les augments, au fil de la partie. Aucun site ne donnait de statistiques précises sur ces choix : je les ai produites moi-même.
- Système
- Crawler en boule de neige sur l'API locale du client League (LCU), stockage SQLite, deux interfaces de restitution (explorateur local + site public au filtrage 100% navigateur).
- Résultat
- 150 140 parties, 1,5M lignes joueur, filtrage/agrégation de 1,5M lignes en 11 à 37ms dans le navigateur.
Le film — 49 s
Lire le texte du film
Dans League of Legends, il y a un mode un peu à part : ARAM Mayhem. On n'y choisit pas son champion, c'est le hasard qui décide. Et quatre fois dans la partie, le jeu vous propose trois bonus, les augments… à vous d'en garder un seul.
Le souci, c'est que le bon choix dépend du champion, et qu'il change à chaque mise à jour. Alors la plupart du temps… on choisit un peu au feeling.
ARAM Mayhem Stats est là pour ça. Le site s'appuie sur plus de quatre cent mille vraies parties pour voir ce qui marche vraiment. Vous lui donnez votre champion, vos trois augments, et il vous dit simplement lequel prendre.
Et quand l'écart est trop faible pour trancher, eh bien il vous le dit aussi, plutôt que de faire semblant.
ARAM Mayhem Stats. Jouez les stats, pas le feeling.
Friction
ARAM : Mayhem est un mode de jeu de League of Legends. Chaque joueur reçoit un champion au hasard, et en cours de partie il choisit des améliorations, les augments, qui changent sa façon de jouer. Avec les objets achetés, ce sont ces choix qui font gagner ou perdre.
Je voulais les taux de victoire des champions sur la file ARAM : Mayhem, mais surtout le détail : avec tel augment, quels objets gagnent le plus, et quelles combinaisons d'objets fonctionnent le mieux.
Cette information n'existait nulle part. On ne trouvait que des tier lists, sans les chiffres derrière le classement et sans pouvoir filtrer selon la question qu'on se posait. Alors je l'ai construite moi-même.
Construction
Puisque l'API publique est fermée sur cette file, le crawler passe ailleurs : par l'API locale du client League (LCU). Il progresse en boule de neige. Chaque partie collectée donne les joueurs qui mènent aux parties suivantes.
La collecte descend dans SQLite, puis remonte par deux interfaces distinctes : un explorateur local pour creuser, et un site public dont le moteur de filtrage tourne entièrement dans le navigateur, sans serveur derrière.
Le crawl est fait pour tourner longtemps sans surveillance : reprise après interruption, détection automatique du patch en cours, et des garde-fous mémoire qui allègent le client League dès que la RAM franchit un seuil.
Système
CLIENT LEAGUE (LCU) CRAWL BOULE DE NEIGE SQLITE (WAL) AGRÉGATS PRÉCALCULÉS EXPORT BINAIRE NAVIGATEUR
Collecte et restitution ne se parlent jamais directement : elles ne partagent que la base. En amont, un pool de threads interroge le client local et écrit dans SQLite en mode WAL, où la lecture ne bloque pas l'écriture. En aval, rien ne relit cette base à chaud. Le site consomme un export figé.
Les tables sont dénormalisées, picks, items et participants séparés, pour qu'une agrégation n'ait aucune jointure à faire ; un pipeline d'agrégats précalculés est posé par-dessus.
Ce qui part vers le navigateur est encodé en binaire : dictionnaire des valeurs, tri, disposition colonne-majeur, décompressé nativement à l'arrivée. Le moteur de filtrage devient alors une passe unique sur des TypedArrays. Aucun serveur n'est interrogé pendant qu'on manipule les filtres.
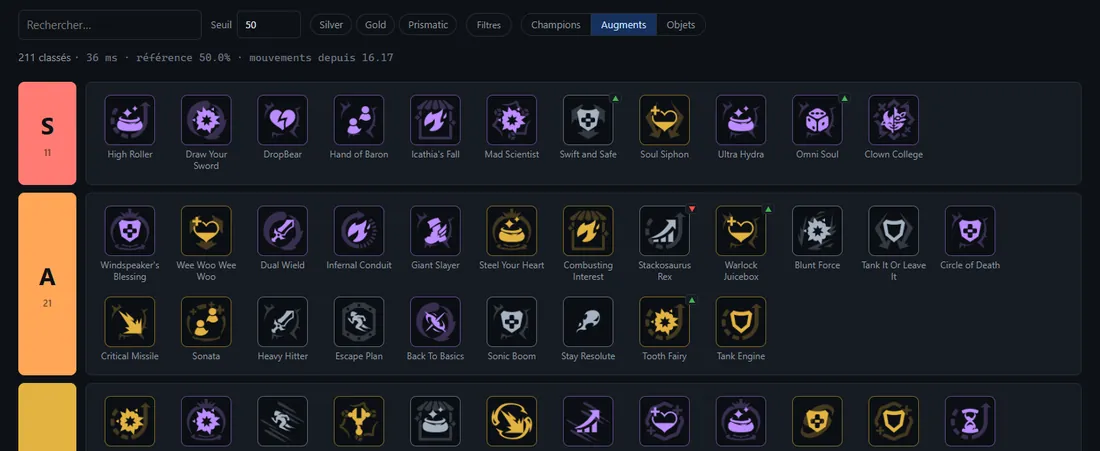
| Augment | Parties | Victoires |
|---|---|---|
| 5 643 | 58,9 % | |
| 31 751 | 57,4 % | |
| 4 336 | 55,8 % | |
| 13 390 | 55,2 % | |
| 6 557 | 55,2 % | |
| 5 744 | 55,0 % | |
| 5 732 | 54,9 % | |
| 4 451 | 54,5 % | |
| 22 440 | 53,5 % | |
| 25 028 | 53,5 % | |
| 25 474 | 53,3 % | |
| 17 576 | 53,3 % |
Données
150 140 parties, 1,5 million de lignes joueur, une base SQLite de 2,0 Go en mode WAL.
La contrainte réelle n'est pas la taille de la base mais ce que le navigateur doit avaler : 9,8 Mo compressés au premier affichage, environ 49 Mo de TypedArrays une fois en mémoire. C'est ce budget-là, et pas le nombre de parties, qui décide de ce que le site peut montrer.
Python 3.11 · SQLite (WAL) · requests / ThreadPoolExecutor · numpy · Pillow · psutil / ctypes · JS vanilla · TypedArray / ArrayBuffer · DecompressionStream · Cloudflare Pages
Résultat
1,5 million de lignes filtrées et agrégées en 11 à 37 ms, dans le navigateur : plus rapide qu'un aller-retour réseau vers un serveur qui aurait fait le même calcul.
Le volume atteint suffit à décider, ce qui était tout l'enjeu. Sur un patch, environ un million de lignes joueur donnent ~10 000 picks pour un augment présent à 1 %, soit un winrate à ±1 point, quand les paliers de tier sont espacés de 1,5 point. La question de départ, quels augments dominent réellement, est devenue tranchable.
Et elle l'est sans identité : l'export public ne contient ni pseudo, ni identifiant de joueur, ni identifiant de partie.
Recul
La limite ne porte pas sur l'astuce d'accès, mais sur ce qui sort de la machine. Le 403 sur cette file est une décision produit, pas une barrière de sécurité, et le client local répond parce que je suis authentifié dans mon propre client, avec mon propre lockfile : rien n'est cassé, aucune authentification n'est forcée. Je ne prétends pas pour autant que ça règle la question. Riot a fermé une porte ; le projet en emprunte une autre pour arriver au même endroit.
La ligne est donc ailleurs, et je la formule ainsi : produire des statistiques agrégées sur l'équilibrage d'un mode de jeu, oui ; construire une surface où l'on retrouve des individus, non. L'export public ne contient aucun identifiant de joueur, aucun identifiant de partie, aucun pseudo. Vérifié à chaque fois que le format binaire a changé. Les cartes d'exemple montrent le champion et le build, rien d'autre. La base locale stocke des identifiants parce que le graphe de crawl en a besoin ; ils s'arrêtent à ma machine.
Lire le recul complet
Sur la tenue du filtrage navigateur, ce n'est pas le calcul qui lâcherait en premier. À 1,5 million de lignes en 11 à 37 ms, le moteur garderait de la marge jusqu'à 10 millions de lignes sous 250 ms. Le mur est ailleurs : le premier affichage coûte déjà 9,8 Mo compressés, et une fois en mémoire les trois blocs pèsent environ 49 Mo de TypedArrays, plus les pics de décompression. Le coût est strictement linéaire. À 5 millions de lignes, soit environ 500 000 parties, le premier affichage passe à ~33 Mo. C'est là que ça meurt, et ça meurt sur mobile bien avant.
L'échappatoire existe et elle est bon marché : découper les fichiers par patch, puisque le site sélectionne déjà la dernière version par défaut. Il ne chargerait qu'un fragment. Cela repousserait le mur d'un ordre de grandeur, toujours sans backend. Je ne l'ai pas fait parce qu'aucun usage ne l'exigeait encore.
Trois choses ont été payées pour en arriver là. La fraîcheur : le site est un instantané daté ; l'explorateur local suit la base en direct, le site attend un réexport. L'ordre : trier les augments et les objets améliore nettement la compression, mais détruit l'ordre de ramassage. Impossible de demander quel augment a été pris en premier, ni d'analyser les choix tour par tour. C'était un vrai arbitrage, pas un oubli, et c'est le plus coûteux des trois. La forme des questions, enfin : le moteur est une passe unique, les filtres sont une conjonction inclure/exclure et rien d'autre. Pas de OU, pas de « au moins 2 parmi ces 3 », pas de série temporelle inter-patch, et surtout pas de matrice de co-occurrence, qui serait en O(n × k²) et incompatible avec la passe unique.
S'y ajoutent six objets finis au maximum, une durée quantifiée à 15 secondes, et aucune identité, donc aucun suivi d'un joueur d'une partie à l'autre, ni rang, ni région. En revanche les dégâts sont restés exacts, en u16 : la quantification s'était révélée fausse sur 1 443 lignes, et là ça méritait de payer.
150 140 parties n'est pas un seuil. La file comptait encore 475 428 joueurs en attente : elle n'était pas épuisée, loin de là. Ce qui a arrêté le crawl, c'est la machine qui saturait, la borne à six heures, puis simplement le fait de ne plus l'avoir relancé pendant des semaines. A posteriori, s'arrêter là était juste : sur le patch 16.16, 102 624 parties donnent environ un million de lignes joueur, et un augment présent à 1 % compte ~10 000 picks, soit un winrate à ±1 point quand les paliers de tier sont à 1,5 point. La partie marginale n'achète plus rien de décidable ; continuer aurait été de la collecte pour la collecte.
Le snowball, oui. La stratégie autour, non. Le snowball reste le seul mécanisme possible : il n'existe aucune liste de joueurs de ce mode, la seule façon de les énumérer est de les découvrir dans les parties des autres. Ce que je referais autrement tient en un point : le crawl visite chaque joueur exactement une fois, pour toujours, alors que la fenêtre du client ne remonte que vingt parties. Le rendement total est donc plafonné par le nombre de joueurs atteints, pendant que les mêmes 13 087 joueurs continuent de jouer tous les jours. Revisiter un joueur actif chaque semaine transformerait une collecte unique en flux continu. C'est ce qui a manqué quand le nouveau patch est sorti.
Second point : la file grossit sans borne, trente-six joueurs empilés pour un visité. Le ramassage est gratuit (il vient avec un détail déjà payé), mais il a laissé un reliquat de 475 000 entrées qui, trois semaines plus tard, s'est retrouvé en travers du chemin. Une file bornée ou vieillissante aurait évité d'avoir à inventer une colonne de priorité.