Projet 03
Commission Copilot
Le LLM explique, le moteur calcule
- Année
- 2026
- Univers
- Finance / conversational AI
- Preuve
- Démo en ligne · Dépôt public · Données fictives
- Statut
- En ligne
25/27questions de référence réussies, aucun montant sans source
API hébergée gratuitement : le premier chargement peut prendre une minute.
En bref
- Friction
- J'avais construit les règles de calcul des commissions : j'étais le seul à les connaître, et chaque question des collaborateurs passait par moi.
- Système
- Un moteur de calcul déterministe chiffre chaque commission ; l'assistant explique les règles et l'appelle en outil dès qu'il faut un chiffre. Chaque montant cité est contrôlé contre les résultats du moteur.
- Résultat
- Démo publique sur données fictives : 25 des 27 questions de référence réussies, aucun montant sans source ni produit inventé.
Le film — 1 min 26
Lire le texte du film
Dans mon entreprise, c'est moi qui ai écrit le code qui calcule les commissions… Et derrière chaque montant, il y a des dizaines de règles : une avance versée à la signature, une reprise si le client résilie trop tôt, des taux qui changent d'un assureur à l'autre.
Le souci, c'est que toutes ces règles, j'étais le seul à les connaître. Alors à chaque fois qu'un collègue se demandait pourquoi un contrat avait rapporté tel montant… ou rien du tout, eh bien, la question finissait chez moi.
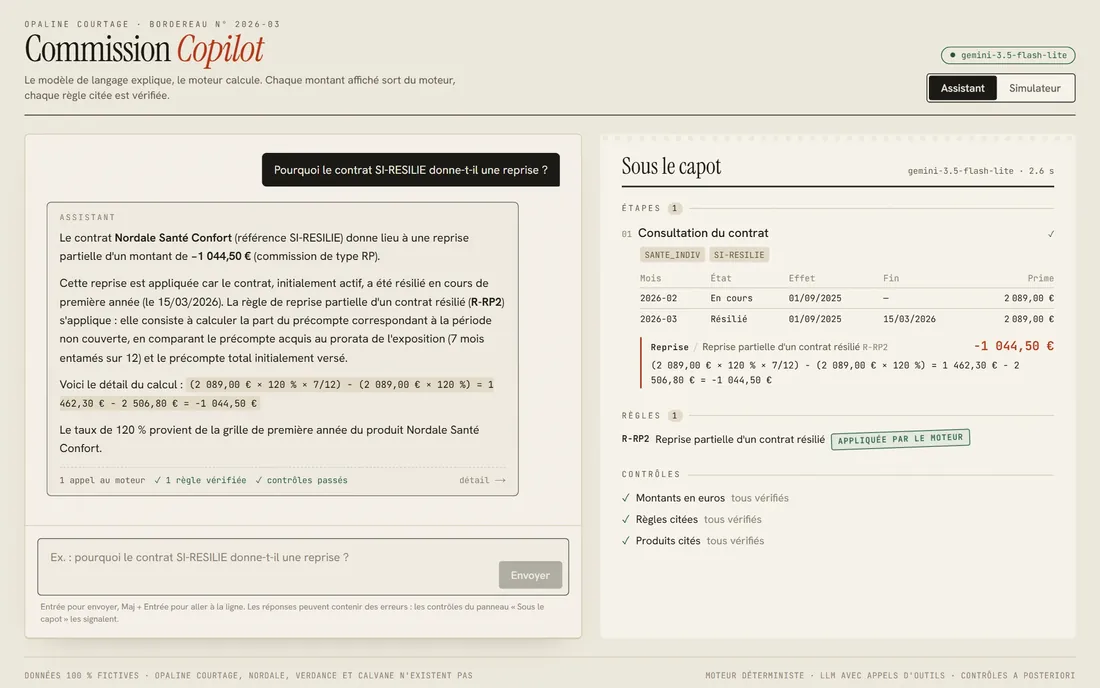
Alors j'ai construit un assistant qui répond à ma place, pour que chacun puisse lui poser sa question directement. Celui-là tourne en interne, sur les vraies données, donc je ne peux pas le montrer… Ce que je montre ici, c'est Commission Copilot : le même outil, que j'ai reconstruit en public, sur un cabinet fictif. On lui demande pourquoi ce contrat résilié donne une reprise de mille quarante-quatre euros cinquante, et il explique la règle, avec la formule.
Et ce qui compte pour moi, c'est qu'il n'invente jamais un chiffre. Ce n'est pas l'IA qui calcule : c'est mon moteur, testé, et chaque montant qu'elle cite est revérifié. Et si on lui demande de calculer de tête, elle refuse.
Commission Copilot. Le modèle explique, le moteur calcule.
Friction
Les règles de calcul des commissions, c'est moi qui les avais construites. J'étais donc le seul dans l'entreprise à vraiment les connaître.
Elles existaient pourtant par écrit, dans le code et dans la documentation que j'avais rédigée. Mais aller lire un script ou une documentation technique pour une question ponctuelle, c'est compliqué quand ce n'est pas son métier. Les collaborateurs préféraient passer par moi, à chaque question.
Chaque réponse prenait du temps et de l'énergie, pour eux comme pour moi. C'est ce passage obligé que j'ai automatisé : un assistant qui répond à ma place, à partir des règles réelles.
Construction
Deux versions. La première, interne, explique les règles de calcul réelles de mon employeur : le script métier et son paramétrage, environ 22 000 tokens injectés tels quels dans le system prompt, après anonymisation des noms internes. Ni RAG, ni outil : le bot explique, il ne calcule jamais. Elle tourne en interne et ne peut pas être publiée.
La seconde, Commission Copilot, est reconstruite de zéro, en public, sur un cabinet de courtage fictif. Elle garde la frontière et change l'architecture : un moteur de calcul déterministe chiffre chaque commission, et l'assistant l'appelle en outil dès qu'il faut un chiffre. Le modèle explique, le moteur calcule, aucun montant ne vient du modèle.
Autour, ce qui en fait un système vérifiable : 27 questions de référence évaluées sans modèle juge, une API FastAPI dont l'interface Next.js reçoit les types générés, une intégration continue qui teste moteur, API et interface, et une démo publique bridée pour tenir dans le quota gratuit du modèle.
Système
QUESTION ASSISTANT (GEMINI) OUTILS TYPÉS MOTEUR DÉTERMINISTE CONTRÔLE DES MONTANTS RÉPONSE SOURCÉE
Le modèle n'a qu'un moyen d'obtenir un chiffre : appeler le moteur, par trois outils (simuler un contrat, consulter un contrat d'exemple, lire le paramétrage d'un périmètre). Il reçoit des montants déjà formatés, qu'il recopie. La boucle est bornée à quatre tours ; au dernier, les outils lui sont retirés et il doit conclure.
Les valeurs qui changent un taux, segment de client ou garantie négociée, sont imposées par énumération dans la définition de l'outil. Le service refuse une valeur inconnue au lieu d'appliquer en silence le taux standard.
Chaque réponse repart avec ses contrôles : les montants absents de toute source, les règles citées avec, pour chacune, si le moteur l'a réellement appliquée, et les règles ou produits qui n'existent pas. Le panneau « Sous le capot » les affiche en direct, avec chaque appel d'outil. Le simulateur de l'interface et l'assistant passent par les mêmes services : ils ne peuvent pas diverger.
Données
Aucune donnée réelle dans la version publique : cabinet, assureurs, produits, taux et contrats sont inventés. Les bordereaux de cinq périmètres, sur deux mois, sont générés par un script déterministe, avec des contrats scénarios dont le nom dit le cas illustré : résilié, taux négocié, sans effet.
Tout ce qui varie d'un périmètre à l'autre (clé de rapprochement, base d'exposition, seuils, taux négociés, exclusions) est déclaré dans un fichier de paramétrage : ajouter un périmètre ne demande aucune ligne de code. Les montants sont calculés en décimal, arrondis au centime explicitement, et chaque ligne porte sa règle, sa formule et la provenance de son taux.
La version interne, elle, lit le vrai script métier : seul ce qui part vers le LLM est anonymisé, les fichiers sources portent les vrais noms de l'employeur. C'est pour cela que la version publique a été reconstruite plutôt qu'expurgée.
Python · FastAPI · API Gemini · Next.js · pydantic · Docker · GitHub Actions
Résultat
Sur 27 questions de référence en six catégories, 25 réussies avec le modèle retenu : aucun montant sans source, aucun produit ni aucune règle inventés, 1,9 s de latence médiane. Les vérifications sont déterministes : outils appelés, montants exacts recalculés par le moteur, règles citées, montants interdits.
L'évaluation a surtout trouvé une erreur qu'aucun contrôle de sortie ne voyait. Pour un client en rachat de crédit, le modèle transmettait le segment RACHAT_CREDIT au lieu de RACHAT : le taux négocié ne s'appliquait pas, et l'assistant annonçait 280 € au lieu de 336 €, en justifiant le mauvais taux. Le montant venait bien du moteur, calculé sur une mauvaise donnée. Les segments autorisés sont désormais imposés dans la définition de l'outil ; le cas passe.
La version interne reste déployée et utilisée, sans métrique d'usage, et des réponses y ont été contestées. C'est de là que part la section suivante.
Recul
Sur la version interne, 22 000 tokens sur 128k, c'est 17 % de la fenêtre : large marge, en apparence. Mais le budget réel n'est pas 128k. Trois choses se dégradent avant la limite dure.
Le coût et la latence d'abord : chaque question refacture les 22 000 tokens en entrée. Doubler la documentation (nouveaux périmètres, nouveaux produits) double le coût par question et la latence, sans aucun gain de qualité. C'est un mauvais rendement, pas seulement un plafond.
Lire le recul complet
L'attention du modèle ensuite. Sur un contexte dense en tableaux et en code, la dégradation arrive plutôt vers 40 à 60k tokens que vers 128k : une règle précise se retrouve moins bien quand elle est noyée dans un gros bloc. Le system prompt contient déjà un résumé métier écrit à la main pour compenser. C'est le signe que le modèle peine sur le code brut dès 22 000 tokens, pas qu'il reste de la marge.
La maintenabilité humaine enfin : le dictionnaire d'anonymisation et ce résumé se mettent à jour à la main, à chaque nouveau périmètre. Ça casse en pratique bien avant de casser techniquement. Le seuil concret n'est donc pas « 128k atteint » : c'est l'ajout d'une deuxième source hétérogène (un second script métier, une documentation PDF, un autre fichier de règles), ou un volume deux à trois fois supérieur.
Ce que je ferais alors, avant un RAG classique : un découpage statique par thème, pas par similarité vectorielle. Un routeur simple, ou le modèle lui-même, choisit quels blocs de règles injecter, chaque bloc restant entier et cohérent. Les règles s'entrecroisent ici, et un chunk isolé perdrait le contexte : voir toutes les règles à la fois est précisément ce qui a de la valeur. Ensuite seulement du cache de contexte pour absorber la répétition, et le RAG en dernier recours.
Le « à retravailler » a un nom : la qualité des réponses. Le bot est déployé et utilisé, des réponses ont été contestées, des cas d'erreur précis ont été remontés. Ce n'est ni un problème d'adoption, ni un problème de confiance en abstrait. La confiance s'érode parce que la qualité est insuffisante, dans cet ordre.
Avec cette architecture, les erreurs viennent structurellement de trois points. L'interprétation du code métier, que le résumé écrit à la main ne mitige que jusqu'au jour où il dérive du code sans que personne ne le remette à jour. La confusion entre deux périmètres proches après anonymisation, quand les préfixes se chevauchent. Et l'absence de traçabilité : rien dans une réponse n'indique quelle règle exacte la fonde, donc l'utilisateur métier ne peut pas vérifier vite, et je ne peux pas savoir pourquoi une réponse a dérapé sans creuser les logs. La suite n'est pas une refonte : c'est creuser les cas d'erreur déjà remontés, où un motif répété sur trois ou quatre exemples vaut plus que n'importe quelle architecture théorique.
Je tiendrais la frontière « expliquer, jamais calculer », et pas par prudence technique. Un modèle qui calcule un précompte rend un nombre avec la même assurance qu'il rend une explication fausse : rien dans sa sortie ne distingue la certitude de l'hallucination. Une explication fausse est visible et corrigible par quelqu'un qui connaît le métier. Un montant faux peut passer inaperçu et devenir une décision financière, ou un chiffre transmis à un tiers. Le risque n'est pas symétrique : l'une coûte de la confiance, l'autre peut coûter de l'argent réel et être difficile à tracer après coup.
Le moteur Python existe précisément pour ça : déterministe, testable, versionné, le même résultat pour les mêmes entrées. Faire calculer le modèle en parallèle recréerait un second moteur de calcul, non déterministe et non auditable, qui pourrait diverger silencieusement du premier, sans que personne ne sache lequel a raison en cas d'écart.
Si on me demandait de lever cette frontière, ma réponse serait : pas via le LLM. Si le vrai besoin est « je veux un chiffre, pas une explication », la bonne réponse est de brancher le bot sur le moteur déterministe en tant qu'outil. Le modèle comprend la question, appelle le moteur avec les bons paramètres, et restitue son résultat exact plutôt qu'une estimation générée.
Commission Copilot est cette évolution, construite hors de l'entreprise, sur des données fictives. Elle répond aussi au troisième point d'erreur : chaque réponse liste les règles qu'elle cite et dit si le moteur les a réellement appliquées. Une règle citée mais non appliquée, ou appliquée mais non citée, devient visible sans fouiller les logs.
Le cas du rachat de crédit a montré la limite de ce contrôle. Vérifier qu'un montant vient du moteur ne dit rien de ce qu'on a donné au moteur. Un garde-fou en sortie ne suffit pas : il faut aussi contraindre l'entrée, ce que fait l'énumération des segments.
Et le score n'est pas un chiffre stable. Trois passages ont donné 24, 23 puis 25 questions réussies, sans échouer sur les mêmes. Les vérifications par mots-clés peuvent rejeter une réponse correcte formulée autrement, et les échecs restants sont surtout des réponses incomplètes. 25 sur 27 mesure une architecture sur un jeu de référence, pas la qualité des réponses sur les règles réelles.
Version interne : 22 000 tokens de documentation sur une fenêtre de 128 000, soit 17 % de la limite théorique. Mais l'attention du modèle se dégrade avant cette limite, autour de 40 000 à 60 000 tokens sur un contexte dense en tableaux et en code. Le contrôle ci-dessous projette une documentation plus volumineuse pour voir où elle tombe.
×1 documentation : 22 000 tokens, soit 17 % de la limite du modèle, sous la zone de dégradation.
22 000 tokens est le volume de la documentation actuelle (17 % de la limite du modèle), et la seule valeur mesurée ici.
Doubler la documentation double le coût et la latence de chaque question sans rien gagner en qualité. On paie deux fois pour le même résultat, sans même avoir approché le plafond théorique. Ni le coût ni la qualité ne sont mesurés aujourd'hui, faute de métrique d'usage sur ce bot. Et la limite qui arrivera d'abord n'est pas celle du modèle. Le jour où une seconde source hétérogène s'ajoute, ou où le volume triple, la maintenance manuelle du dictionnaire d'anonymisation et du résumé métier lâche pendant que le contexte, lui, tient encore.