Projet 04
AI Watch
Veille IA autonome
- Année
- 2026
- Univers
- Information / temporalité / flux
- Preuve
- Démo en ligne · Dépôt public
- Statut
- En ligne
−26 %de volume collecté, pour 5 % des éléments utiles perdus
En bref
- Friction
- Suivre à la main l'actualité IA sur ~34 sources : trop de volume pour tout lire, et aucun moyen de savoir quelles sources valent la peine.
- Système
- Collecteur autonome (GitHub Actions) qui agrège les flux, score chaque item selon un profil de pertinence, publie un digest quotidien + hebdomadaire, avec une version publique expurgée où chaque lecteur apporte sa propre clé API.
- Résultat
- 15 733 fiches en base, rendement arbitré source par source (7 sources désactivées).
Le film — 1 min 14
Lire le texte du film
Quand on suit l'IA de près, il se passe quelque chose tous les jours : un nouveau modèle, une mise à jour, un article de blog, un fil sur X… Et pour ne rien rater, il faut faire le tour d'une trentaine de sources, chaque matin, et lire beaucoup de choses qui, au final, ne servent à rien.
Le souci, c'est que le volume ne dit rien… Une source peut publier énormément, et ne rien apporter du tout.
Alors j'ai construit Veille IA. Chaque jour, il fait le tour des sources à ma place, il enlève les doublons, et il note chaque article selon ce qui m'intéresse vraiment : Claude et Claude Code d'abord. Aujourd'hui, sur soixante-huit articles, il en a gardé trois. Moi, je n'ai plus qu'à lire le point du jour… ou à l'écouter.
Et il note aussi ses propres sources. Pour chacune, je vois ce qu'elle rapporte vraiment : sept d'entre elles faisaient un quart du volume, pour cinq pour cent de l'utile… alors je les ai coupées. Et le tout tourne seul, dans le cloud, sans qu'aucune machine ne reste allumée.
Veille IA. Il lit tout, je lis l'essentiel.
Friction
Suivre l'actualité IA sur environ 34 sources, c'est relire chaque jour des flux où l'essentiel se noie dans le bruit.
Et le volume ne dit rien de l'utilité : une source très productive peut ne rien apporter, une source qui publie deux fois en trois semaines peut être la plus précieuse. Sans mesure, impossible de savoir lesquelles garder, et le tri revient à la main.
Construction
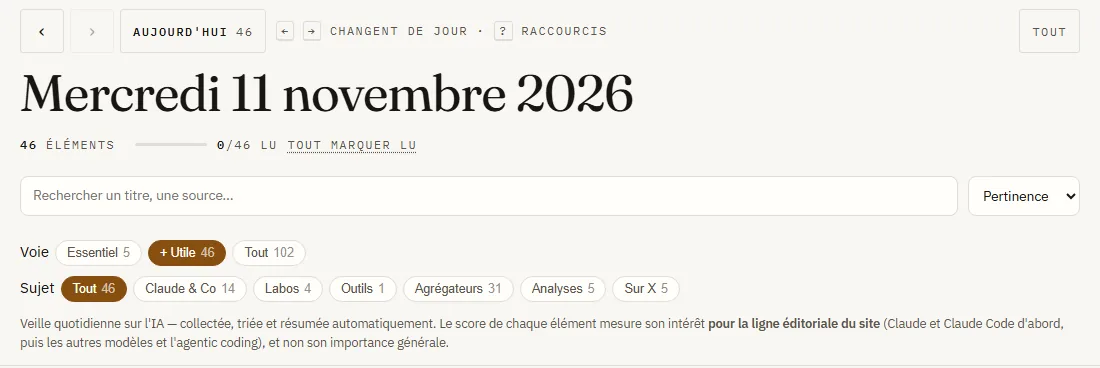
Un collecteur qui tourne seul sur GitHub Actions. Aucun PC allumé n'est requis. Il agrège 39 sources en RSS, scraping ciblé et posts X, score chaque item, et publie un digest quotidien à 05:00 UTC. La synthèse hebdomadaire est retentée après chaque quotidien tant qu'elle manque.
Le scoring ne juge pas un article dans l'absolu : il le confronte à un profil de pertinence personnel (agentic coding, Claude Code, automatisation, migration SAS → Python), via l'API Gemini, sur son tier gratuit. Un article développé à la demande l'est à partir du contenu réel de la page, pas du seul titre.
Le même générateur produit une seconde version, publique et expurgée, en ligne depuis le 17 septembre : elle republie les actualités, jamais les résumés personnels. Chaque lecteur y développe un article avec sa propre clé API. Elle ne quitte pas son navigateur, rien n'est collecté, et l'hébergement ne me coûte rien. Le site s'installe sur un téléphone et sert aussi un flux RSS des éléments essentiels.
Système
39 SOURCES COLLECTE (CRON) SCORING PAR PROFIL DIGEST VAULT OBSIDIAN
Deux boucles cohabitent et ne partagent que le collecteur. La première est privée : le cron déclenche la collecte, chaque item est scoré contre le profil, et le digest est écrit dans le vault Obsidian. Le vault est le stockage. Il n'y a pas de base séparée à maintenir à côté.
La seconde est publique : le même générateur produit une version expurgée, déployée sur Cloudflare Pages. Les résumés personnels ne franchissent jamais cette frontière ; seules les actualités passent.
Développer un article n'appartient à aucune des deux. Un Worker Cloudflare récupère le contenu réel de la page, et l'appel au modèle part du navigateur du lecteur avec sa propre clé : rien ne passe par mon quota, rien n'est stocké côté site.
Le site se mesure lui-même. Son onglet Tendances, calculé dans la page à partir des archives, suit le rythme des journées, les sujets qui montent et le rendement de chaque source active. C'est lui qui a signalé une source muette depuis vingt-quatre jours, sans que je la cherche.
Les 34 sources déclarées de la veille, classées deux fois sur les mêmes nombres : par volume collecté, puis par rendement (la part de ce volume jugée utile). Rien n'est recalculé au changement de tri, le classement se contente de se relire dans l'autre sens.
Fenêtre du 2026-08-04 au 2026-08-22 (19 jours) · seuil utile 0,5 · Les items de categorie 'signets' (comptes X, pipeline collecte_signets.js) sont exclus : ce ne sont pas des sources de sources.yaml.
- r/LocalLLaMA375 items · 158 utiles · 42 %
- Hacker News212 items · 91 utiles · 43 %
- Next.ink138 items · 9 utiles · 7 %
- r/MachineLearning114 items · 10 utiles · 9 %
- Simon Willison51 items · 33 utiles · 65 %
- OpenAI News35 items · 5 utiles · 14 %
- Claude Blog (produit)21 items · 18 utiles · 86 %
- LangChain (releases)21 items · 15 utiles · 71 %
- Latent Space18 items · 7 utiles · 39 %
- Hugging Face18 items · 5 utiles · 28 %
- Claude Code (releases)17 items · 14 utiles · 82 %
- TLDR AI13 items · 2 utiles · 15 %
- The Zvi10 items · 0 utile · 0 %
- Ben's Bites9 items · 0 utile · 0 %
- AI News (smol.ai)8 items · 3 utiles · 38 %
- Google AI6 items · 0 utile · 0 %
- Claude Code (documentation)5 items · 5 utiles · 100 %
- Google Research5 items · 0 utile · 0 %
- Interconnects (Nathan Lambert)5 items · 1 utile · 20 %
- OCTO Technology5 items · 0 utile · 0 %
- Google DeepMind4 items · 1 utile · 25 %
- Cursor (changelog)3 items · 2 utiles · 67 %
- Anthropic News2 items · 2 utiles · 100 %
- Mistral AI2 items · 2 utiles · 100 %
- Import AI (Jack Clark)2 items · 0 utile · 0 %
- Sebastian Raschka1 item · 0 utile · 0 %
- MCP — serveurs (releases)1 item · 0 utile · 0 %
- The Batch (Andrew Ng)0 item sur la fenêtre
- MCP — spécification (releases)0 item sur la fenêtre
- ActuIA0 item sur la fenêtre
- Cafétech0 item sur la fenêtre
- LinuxFr0 item sur la fenêtre
- Numerama0 item sur la fenêtre
- L'Usine Digitale0 item sur la fenêtre
Sur la fenêtre, hors signets (comptes individuels, pipeline distinct) : 1 101 items, 383 jugés utiles. Les sept sources coupées au rendement représentaient 287 de ces items pour 19 utiles. 27 des 34 sources déclarées ont produit au moins un item sur la fenêtre, 7 n'en ont produit aucun.
Données
Le 22 août, jour de la mesure : 15 733 fiches en base, dont 180 nouvelles ce jour-là, pour 34 sources suivies.
Les sources ne sont pas arbitrées au volume mais au rendement, mesuré source par source : Claude Code documentation ressort à 100 % d'éléments jugés utiles, Next.ink à 7 %. Sept sources ont été désactivées sur cette base, soit 26 % du volume collecté pour 5 % de ce qui servait vraiment. Il en restait 23 actives.
La liste a été rouverte le 26 septembre, sur deux manques constatés à l'usage : les posts de l'équipe Claude Code sur X, et tout ce qui n'est pas Claude. Le blog Engineering d'Anthropic manquait depuis le début ; AI News, dont le flux était figé depuis le 9 septembre, a cédé sa place à The Decoder. Les posts X arrivent sans session, par un fichier public régénéré chaque matin par un projet open source. 39 sources actives, toutes vérifiées depuis GitHub Actions.
Python · GitHub Actions · API Gemini · feedparser / httpx · Cloudflare Pages + Worker · Obsidian
Résultat
Le système tourne dans le cloud sans qu'aucune de mes machines soit allumée. L'arbitrage du 22 août a laissé 23 des 34 sources actives ; la liste en compte 39 depuis sa réouverture fin septembre, et leur rendement reste à mesurer.
La mesure a produit un effet net : les sept sources coupées pesaient 26 % du volume collecté pour 5 % de ce qui était jugé utile. Retirer un quart du bruit en perdant un vingtième de la valeur. Voilà le résultat, pas le nombre de fiches accumulées.
Recul
Sept sources coupées, mais le vrai risque tenait à deux autres. Anthropic News et Mistral AI ont été explicitement épargnées malgré deux éléments en dix-neuf jours, parce que leur rendement restait à 100 % : le critère retenu est le rendement, pas le volume, et c'est ce qui les a sauvées.
Les sept coupées, elles, avaient soit un rendement mesuré sous 10 %, soit zéro élément utile en dix-neuf jours. Pour une source qui publie plusieurs fois par semaine, zéro sur dix-neuf jours n'est pas un échantillon fragile.
Lire le recul complet
Ce que je n'ai pas vérifié avant de couper : si l'une d'elles publie par rafales rares et à forte valeur, un article par mois qui compterait, noyé dans dix-huit jours de bruit. Dix-neuf jours ne couvrent pas un cycle mensuel. C'est un angle mort réel de la mesure, pas seulement une possibilité théorique.
Et je ne rejugeais que passivement : « refaire la mesure sur un mois complet » est resté une ligne du journal, faite en retard. Depuis fin septembre, l'onglet Tendances tient le rendement de chaque source à jour en continu, et c'est lui qui a repéré AI News, muette depuis vingt-quatre jours. Mais il ne voit que les sources actives : ce que les sources coupées auraient apporté reste invisible. Le contrôle honnête reste à construire : garder les flux désactivés en veille silencieuse, collectés mais ni scorés ni publiés, pour comparer sur un mois ce qu'ils auraient produit contre ce qu'ils ont raté.
Le profil de pertinence, lui, ne bouge pas, et je ne sais pas ce qu'il m'a fait manquer : rien dans le système ne détecte un désalignement entre ce profil et ce qui m'intéresse réellement maintenant. C'est la faille structurelle de la conception. Le scoring est un filtre à sens unique, sans boucle de retour qui dirait « ce que tu ignores depuis trois semaines redevient pertinent », ou l'inverse.
Un signal existe pourtant, indirect : les favoris. Un élément classé « bruit » mais mis de côté à répétition serait le signe que le profil sous-évalue quelque chose. Rien ne l'agrège aujourd'hui. Les favoris sont stockés, jamais réinjectés dans le profil ni dans le prompt de scoring.
La correction à court terme est manuelle et concrète : relire une fois par mois les éléments notés « bruit » de la semaine et vérifier à la main si l'un d'eux aurait dû remonter. Cinq minutes, mais qui ferment la boucle que le système n'a pas. À plus long terme, faire dériver une partie du poids de scoring des favoris effectivement gardés, pour que le profil déclaré et le comportement réel se recalent l'un sur l'autre au lieu de diverger silencieusement.
Une autre panne est restée silencieuse une semaine. Du 18 au 24 septembre, cinq exécutions sur neuf sont tombées sur la même saturation de Gemini, et la synthèse de la semaine 38 n'a jamais été écrite. Je ne l'ai vu qu'en regardant le site : le calendrier sautait des jours. Trois défauts, dont deux silencieux : un seul modèle, sans repli ; une seule tentative pour l'hebdomadaire ; une fenêtre de collecte fixe de 36 heures, qui couvrait un run manqué mais pas deux. Le pipeline essaie désormais deux modèles de secours, retente l'hebdomadaire tant qu'il manque, et fait remonter sa fenêtre jusqu'à la dernière exécution réussie.
Le BYOK a un coût que je ne minimise pas, et qu'il vaut mieux redire sans filtre : la fonctionnalité phare du site public, « développer un article », est cassée par défaut pour n'importe quel visiteur qui ne s'attend pas à devoir créer un compte et coller une clé API avant de cliquer sur un bouton. Aucun utilisateur d'un produit grand public n'accepterait cette friction sans explication préalable.
Pire : le mode dégradé sans clé, titre et extrait, est exactement celui qui avait produit l'erreur factuelle à l'origine de la lecture complète des articles. Le visiteur sans clé récupère donc précisément le défaut que la fonctionnalité a été conçue pour éliminer.
Je l'assume tel quel, mais pas sans réserve. La contrepartie est réelle : zéro coût d'hébergement, aucune clé personnelle exposée, aucune dépendance à mon quota. Et elle est alignée avec ce qu'est ce projet. Un outil personnel rendu public par générosité, pas un produit avec des utilisateurs à convertir. Si l'objectif changeait, si l'intention devenait de le faire vraiment adopter plutôt que de le rendre consultable, l'arbitrage ne tiendrait plus : il faudrait soit absorber un budget partagé avec un plafond dur, soit assumer que « développer » reste réservé aux utilisateurs avertis, et l'afficher dès l'accueil au lieu de le laisser découvrir au clic.